Depth Anything V2 是什麼?能解決什麼問題、怎麼用與最低硬體需求
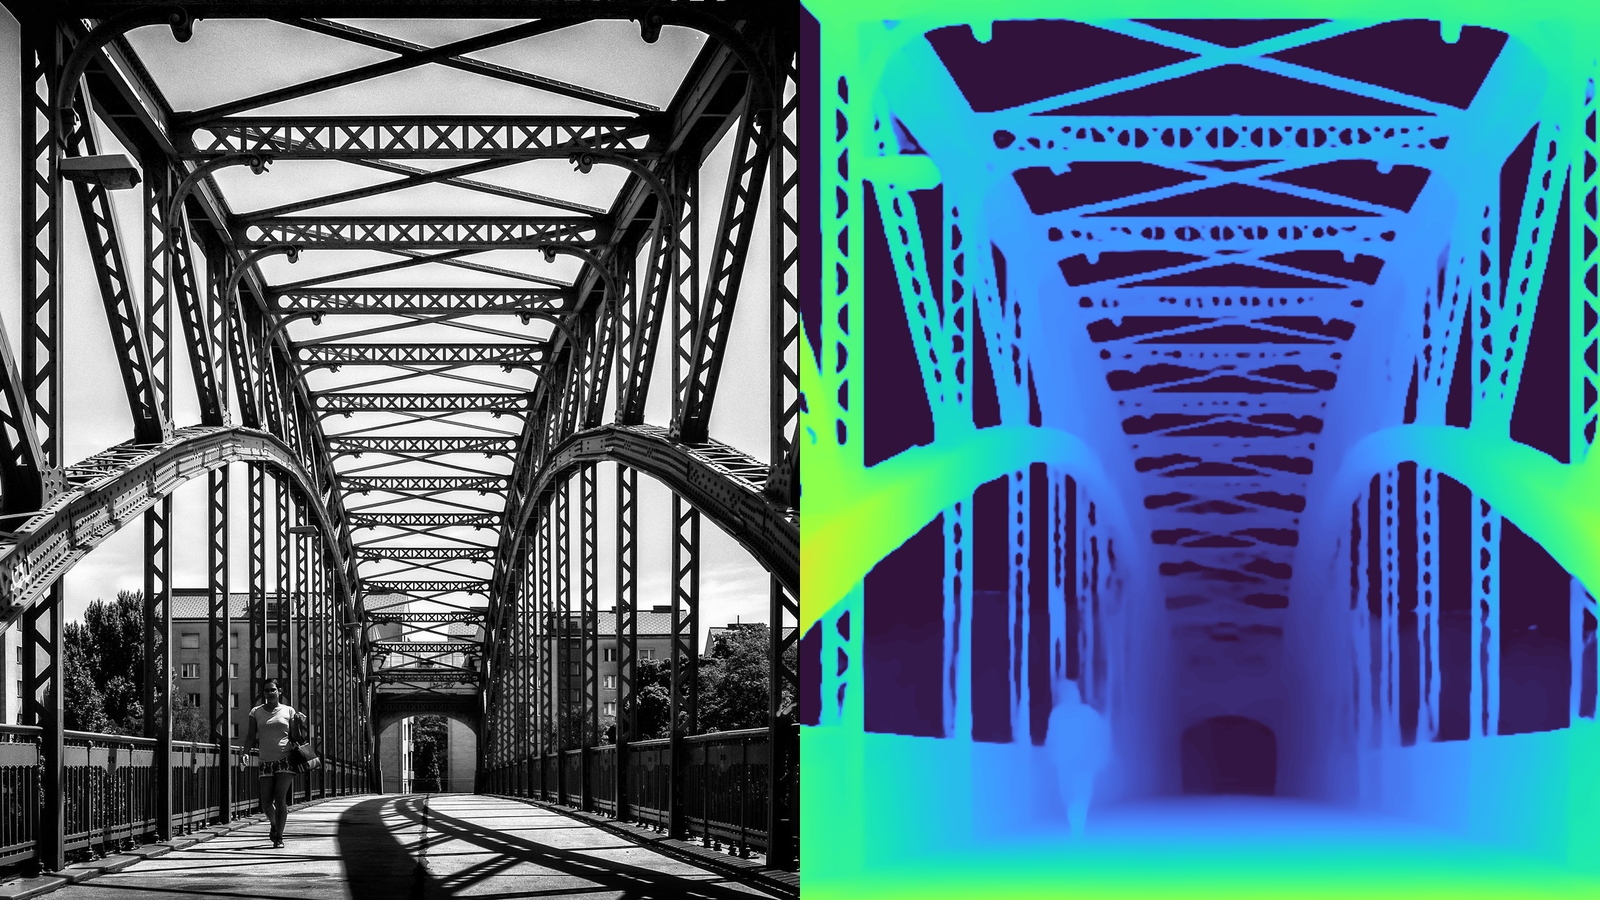
從相對深度、Metric Depth 到圖片與影片工作流,整理 Depth Anything V2 的實際用途、模型選擇、最低硬體、推論時間與部署限制。
作者
Seer
日期
2026-08-03
Depth Anything V2 是什麼?能解決什麼問題、怎麼用與最低硬體需求
當一張普通照片僅包含 RGB 色彩資訊時,電腦很難直觀地解讀出畫面中的空間維度:
- 哪些物體距離較近,哪些又隱沒在後方?
- 背景與主體之間隔了多遠的距離?
- 如何讓一張平面圖片產生動態的鏡頭推移效果?
- 影片每一幀的景深遮罩該如何高效率建立?
Depth Anything V2 是一款專為單張 RGB 圖像估算深度所設計的電腦視覺模型。它免去了雙鏡頭、LiDAR 或多張照片重建的繁瑣步驟,只需輸入單張圖片即可生成深度圖(Depth Map),進而為後續的影像工具提供畫面中各元素的相對遠近資訊。
在官方的程式庫(Repository)中,此模型被定位為單目深度估計(Monocular Depth Estimation)。值得注意的是,官方提供的核心模型主要輸出的是「相對深度(Relative Depth)」,而非直接具備真實物理尺寸(如公尺)的 3D 掃描結果。
這兩者之間的關鍵差異如下:
一般版 Depth Anything V2
→ 用於判斷前後層次與相對遠近

Metric Depth 版本
→ 在指定的室內或室外場景下,估算以公尺為單位的深度值
本文將以官方 Depth Anything V2 為核心,整理它能解決哪些實際問題、如何安裝與使用、不同規格的模型該如何挑選、最低硬體配備如何估算,以及圖片和影片的轉換速度表現。
先講結論
如果您的應用場景是:
- 將平面圖片轉換為深度圖;
- 製作背景模糊或景深效果;
- 製作 2.5D 視差動畫與虛擬鏡頭移動;
- 為 ControlNet、3D 重建或合成工作流準備深度圖控制條件;
- 以低成本替代人工繪製的前後景遮罩。
那麼 Depth Anything V2 Small 會是相當理想且合理的起點。
如果您的需求更傾向於:
- 追求更細緻的物件邊緣細節;
- 在複雜場景中維持深度的穩定性;
- 需要室內或戶外場景的實際公尺距離;
- 進行學術研究或高品質的離線批次處理。
此時再考慮往 Base、Large 或 Metric Depth 版本升級。
但若您需要的是:
- 可用於精準量測真實距離的完整 3D 掃描;
- 保證幾何絕對正確的機器人避障系統;
- 長影片中完全不閃爍且高度連續的深度資訊;
- 已完成相機標定的精準點雲數據。
單靠 Depth Anything V2 無法保證達成上述目標。它本質上是一個深度估計器,而非 LiDAR、SLAM 或完整的 3D 重建系統。
可以用在哪些地方?
| 使用場景 | Depth Anything 提供什麼 | 後續還需要什麼 |
|---|---|---|
| 商品圖與人像背景模糊 | 距離導向的深度圖 | 模糊半徑設定、邊界修正與人工品管檢視 |
| 圖片轉 2.5D 短影音 | 前景、中景與背景的相對層次 | 視差動畫製作、圖像修補、字幕與剪輯 |
| AI 影像生成 | 深度條件引導(Depth Conditioning) | ControlNet 或其他支援深度控制的生成流程 |
| 圖片合成與遮擋排序 | 物件前後的層次關係 | 影像分割、遮罩與合成規則設定 |
| 室內/戶外粗略距離估計 | Metric Depth 數據輸出 | 挑選正確的室內/室外權重並驗證場景 |
| 點雲與粗略 3D 前處理 | 深度數值資訊 | 相機內參、點雲清理與多視角對齊驗證 |
| AR / 機器人視覺輔助 | 場景深度的候選參考訊號 | 多感測器融合與安全性驗證 |
| 影片深度前處理 | 每幀圖像的深度圖 | 時間連續性優化、平滑化處理與影片後製 |
該模型最適合用於「原本需要耗費人工繪製深度或配備額外感測器,如今可直接透過 RGB 圖片快速生成首版空間資訊」的工作流程。不建議直接用於高精度測距、安全避障或完整的 3D 掃描。
一、Depth Anything V2 到底在做什麼?
它的運作機制非常單純:輸入一張普通的 RGB 圖片,隨即輸出與畫面完全對應的深度圖。
輸出的深度圖通常可以表現為:
- 黑白灰階圖;
- 彩色熱力圖(Disparity Heatmap);
- 16-bit 原始深度/視差數據(Raw Depth / Disparity);
- NumPy 陣列;
- 作為後續 3D 點雲或遮罩處理流程的輸入。
官方範例中的 infer_image() 函數會輸出 H×W 尺寸的 NumPy 深度圖。官方提供的 run.py 預設採用 518 的輸入尺寸,您也可以調高此解析度,以換取更細緻的邊緣表現,但相應地會增加推論時間。
相對深度不等於實際距離
相對深度主要用於回答以下問題:
- A 物體是否比 B 物體更靠近相機?
- 哪些像素屬於前景,哪些屬於背景?
- 背景應該套用多大程度的模糊?
- 當鏡頭向左移動時,哪些區域的位移量應該比較大?
- 畫面中各物件的繪製與遮擋順序為何?
但它通常無法準確回答:
- 這面牆距離相機是否剛好為 4.2 公尺?
- 這名行人距離車輛是否為 1.1 公尺?
- 兩張不同照片中的深度數值能否直接進行橫向比較?
不同圖片的相對深度並不共用同一個絕對尺度。若有估算公尺深度的需求,請務必改用官方經過特定微調的 Metric Depth 模型,並依據場景選擇室內(Indoor)或室外(Outdoor)的權重。
二、它能解決什麼問題?
1. 自動生成前後景層次資訊
在過去,許多影像特效若想知道畫面中像素的遠近關係,通常必須依賴:
- 人工逐幀繪製遮罩;
- 影像分割模型(Segmentation);
- 特殊的深度相機;
- 多視角圖片重建;
- 手動區分前景與背景圖層。
Depth Anything V2 則能快速提供一張基礎深度圖,作為立體空間結構的初始參考。它雖然無法完全取代精細的分割模型,但能減少前後景關係建立前的人工整理時間。
2. 背景模糊與景深效果
透過深度圖,我們可以建立基於距離變化的漸進式模糊效果:
RGB 圖片
  + 深度圖
  → 依深度計算模糊半徑
  → 保留近景細節
  → 模糊遠端背景
此技術非常適用於:
- 電商商品照的背景模糊處理;
- 人像照片的虛擬大光圈景深;
- 影片背景的柔化合成;
- 需要批次處理大量素材以產生景深效果的流程。
需留意的是,模型有時會在頭髮、玻璃、反光材質、細小分支或色彩過於相似的區域產生誤判。在正式的商業應用中,仍建議保留人工檢視與微調的步驟。
3. 2.5D 視差動畫與虛擬鏡頭移動
將一張靜態圖片轉化為 2.5D 動畫時,可以利用深度圖讓前景與背景以不同的速度移動,從而營造出空間感:
背景(深度值較遠) → 位移速度較慢
主體(深度值較近) → 位移速度較快
這能實現:
- 左右搖擺平移(Parallax);
- 推近與拉遠的縱深移動;
- 偽 3D 的視覺體驗;
- 靜態海報的層次化動態效果。
這畢竟不是真正的 3D 重建。當鏡頭位移過大時,原圖被遮擋的部分會暴露出來形成空洞,此時需搭配影像修補(Inpainting)或生成式 AI 工具來填補缺失的資訊。
4. 深度控制的影像生成與合成
深度圖能作為其他生成式 AI 模型的引導條件,例如:
- 深度引導的圖像生成;
- ControlNet 深度控制工作流;
- 保持參考圖的空間構圖與排版;
- 在局部重繪時維持既有的物體遮擋關係。
它解決的是「擷取原圖的空間結構」這一環節,後續的實際生成品質仍高度依賴所使用的生成模型、深度圖的精細度以及控制權重。
5. 2D 圖像轉點雲的前置流程
官方 Metric Depth 的說明文件中提供了 depth_to_pointcloud.py 腳本,可將深度預測結果投影至 3D 空間生成點雲。
其基本流程如下:
原始圖片
  → Metric Depth 模型
  → 取得物理深度值
  → 結合相機內參
  → 投影為 3D 點雲
在此流程中,相機內參(Camera Intrinsics)至關重要。若無法取得精確的焦距、主點等相機參數,生成的點雲僅能作為視覺化參考或粗略的幾何估算,無法直接應用於高精度量測。
6. 機器人、AR 與視覺前處理
深度估計可以作為:
- 機器人視覺的候選深度訊號;
- AR 遮擋排序的前處理;
- 場景理解的輔助輸入;
- 物件抓取與空間分析的初步資料。
但這些用途涉及安全與幾何精度時,不能只依賴單張圖片的估計。反光、透明物、低光、重複紋理和未知相機姿態都可能導致錯誤。
7. 跳舞、武打與高速動作場景
這類畫面很適合拿來做深度前後處理,因為觀眾看到的不只是人物本身,還包括人物、道具、舞台和背景之間不斷變化的遮擋關係。
跳舞與表演
可以用深度圖處理:
- 舞者與舞台背景的前後分層;
- 多位舞者的遮擋排序;
- 手腳動作前後的光效與粒子;
- 人物與背景之間的煙霧、光束與景深;
- 以人物深度做 2.5D 鏡頭推拉與視差;
- 舞台影像的背景替換或合成。
武打與動作片段
可以用來輔助:
- 人物、武器與背景的遮擋關係;
- 前景拳腳與後景人物的層次;
- 衝擊波、煙塵、火花等效果的深度排序;
- 動作人物與新背景的合成;
- 虛擬攝影機移動與場景視差;
- 將單一鏡頭拆成前景、中景、背景進行後期處理。
但 Depth Anything 只負責估算空間深度,不會直接理解「這是拳頭、腳、刀,還是哪個關節正在移動」。實際的動作工作流通常要把模型分工:
影片
  → Video Depth Anything / Depth Anything
  → Pose Estimation:取得關節與骨架
  → Segmentation / Tracking:追蹤人物、手腳與武器
  → 深度時間平滑:減少逐幀跳動
  → 粒子、光效、遮罩與合成
高速動作有幾個特別容易失敗的地方:
- 動態模糊讓手腳輪廓消失;
- 人物互相遮擋時,深度排序可能跳動;
- 武器、玻璃或反光物件難以估計;
- 快速鏡頭移動會讓逐幀 depth 產生閃爍;
- 同一人物的前後肢體可能被估成相近深度。
如果是短片或單張關鍵幀,可以先用 Depth Anything V2 做深度分層。如果是完整舞蹈或武打影片,應優先測試官方後續的 Video Depth Anything,再搭配姿態、分割與追蹤模型。Video Depth Anything 的定位是長影片的一致深度估計,不是動作辨識或骨架追蹤器。
三、官方模型怎麼選?
官方 V2 程式庫提供了不同參數量的一系列相對深度模型:
| 模型名稱 | 參數量 | 官方權重檔案大小(約值) | 建議適用場景 |
|---|---|---|---|
| Small / ViT-S | 24.8M | 95 MiB | 個人本機開發、批次處理、即時原型測試、低硬體成本部署 |
| Base / ViT-B | 97.5M | 372 MiB | 品質與運算速度的折衷方案 |
| Large / ViT-L | 335.3M | 1.25 GiB | 追求高品質的離線批次處理、結構複雜的場景 |
| Giant / ViT-G | 1.3B | 官方標示為 Coming soon | 目前不列入一般部署的考量範圍 |
註:權重大小是根據 Hugging Face 檔案回應之 Content-Length 換算而得,實際磁碟佔用與快取大小可能會因系統環境而異。
Small 模型
Small 是最推薦作為開發起點的版本:
- 權重極小,載入迅速;
- 即使沒有 GPU,單靠 CPU 也能運行;
- 支援 Apple Silicon 的 MPS 加速;
- 適合圖片的批量處理與一般的影片前處理;
- 易於整合至輕量化本機工具或小型 Web 服務中。
若僅需要一張堪用的深度圖來做後續的創意處理,從 Small 開始通常比直接下載 Large 模型更具效率。
Base 模型
Base 模型在品質與推論效能之間取得了平衡:
- 對於邊界較為複雜的物體,細節處理通常優於 Small 版本;
- 權重體積與執行期的記憶體需求有明顯增加;
- 適用於對素材品質有一定要求的研究比對與離線處理流程。
Large 模型
Large 模型適用於以下情境:
- 對圖像細節、精確度與場景一致性有嚴格要求;
- 無需追求即時處理的反應速度;
- 部署環境配備了高規格 GPU 或充足的系統記憶體。
不建議將 Large 作為首選的默認版本。該模型體積龐大且非常消耗記憶體;在實測中,於 16GB 記憶體的 Apple Silicon Mac 上使用 MPS 處理 518 尺寸的輸入時,便曾發生記憶體不足(Out of Memory, OOM)的情況。
授權協議說明
目前官方 GitHub 標示的授權條款如下:
- Depth-Anything-V2-Small:採用 Apache-2.0 授權;
- Base / Large / Giant:採用 CC-BY-NC-4.0 授權(僅限非商業用途)。
若您的目標是開發商業產品、客戶專案或提供收費 API,務必仔細核對所使用之 Checkpoint 與該 Repository 的授權條款。使用 Metric Depth 的 Checkpoint 時也應查閱對應的模型卡片,切勿直接套用相對深度模型的授權結論。
四、Relative Depth 與 Metric Depth 怎麼選?
Relative Depth(相對深度)
官方的主力模型,輸出像素間的相對遠近關係。適用於:
- 背景虛化與景深合成;
- 2.5D 視差特效;
- 建立深度遮罩;
- 影像生成模型的引導條件;
- 圖層先後順序排列與視覺創意。
Metric Depth(絕對深度)
官方另外針對特定場景微調了三種 Encoder 架構的絕對深度模型:
| 場景分類 | 訓練資料集 | 最大深度限制設定 | 建議適用場景 |
|---|---|---|---|
| Indoor(室內) | Hypersim | 20m | 室內空間的距離估算 |
| Outdoor(戶外) | Virtual KITTI 2 | 80m | 戶外場景與街景的距離估算 |
官方提供的範例會透過 hypersim 或 vkitti 來載入模型,並設定 max_depth 為 20 或 80 進行推論,輸出以公尺為單位的 H×W 深度矩陣。
請避免將室內模型套用於戶外大場景,或將室外模型當作室內精密量測工具。模型的選用必須與實際拍攝場景嚴密對齊。
五、怎麼安裝與使用?
官方 Repository 安裝步驟
依據官方 README 的標準安裝流程:
git clone https://github.com/DepthAnything/Depth-Anything-V2
cd Depth-Anything-V2
pip install -r requirements.txt
其中 requirements.txt 主要包含以下依賴:
- PyTorch
- torchvision
- OpenCV
- matplotlib
- Gradio(用於 WebUI 展示)
下載模型權重後,請統一放置於 checkpoints 資料夾內。
單張圖片與批次處理
python run.py \
  --encoder vits \
  --img-path assets/examples \
  --outdir depth_vis
--img-path 參數可以指定為:
- 單張圖片的路徑;
- 包含多張圖片的資料夾路徑;
- 記錄多個圖片路徑的文字檔。
此外,您還可以視需求加上以下參數:
--input-size 518
--pred-only
--grayscale--input-size:設定推論時的圖像輸入尺寸;--pred-only:僅保存預測出的深度圖,不與原圖做並排對比;--grayscale:直接輸出灰階格式的深度圖。
提升輸入尺寸通常能獲得更豐富的細節,但也會增加運算時間與記憶體開銷。建議先以 518 作為基準,切勿在初始階段直接拉到最大。
Python API 調用範例
import cv2
import torch

from depth_anything_v2.dpt import DepthAnythingV2

DEVICE = (
    'cuda' if torch.cuda.is_available()
    else 'mps' if torch.backends.mps.is_available()
    else 'cpu'
)

model_configs = {
    'vits': {
        'encoder': 'vits',
        'features': 64,
        'out_channels': [48, 96, 192, 384],
    },
    'vitb': {
        'encoder': 'vitb',
        'features': 128,
        'out_channels': [96, 192, 384, 768],
    },
    'vitl': {
        'encoder': 'vitl',
        'features': 256,
        'out_channels': [256, 512, 1024, 1024],
    },
}

encoder = 'vits'
model = DepthAnythingV2(**model_configs[encoder])
model.load_state_dict(
    torch.load(
        f'checkpoints/depth_anything_v2_{encoder}.pth',
        map_location='cpu',
    )
)
model = model.to(DEVICE).eval()

raw_img = cv2.imread('input.jpg')
depth = model.infer_image(raw_img)
官方腳本會嘗試自動偵測 CUDA、MPS 或 CPU 作為推論裝置。但在實際進行系統整合時,仍應注意確保模型與輸入張量(Tensor)位於同一個硬體裝置上,特定 PyTorch 與 MPS 版本可能需要明確地指定 Device。
Transformers 整合版本
官方也提供了與 Hugging Face Transformers 的整合調用方式:
from transformers import pipeline
from PIL import Image

pipe = pipeline(
    task='depth-estimation',
    model='depth-anything/Depth-Anything-V2-Small-hf',
)

image = Image.open('input.jpg')
result = pipe(image)
depth = result['depth']
官方特別指出,其程式庫中採用的 OpenCV 與 Hugging Face 內部使用的 Pillow 在影像縮放(Resize)與上採樣(Upsampling)演算法上有些微差異,因此兩者的預測結果可能會存在輕微偏差。若要求與官方論文完全一致的結果,請優先採用官方 repo 的推論實作。
六、最低硬體配置需求
官方並未提供一份適用於所有硬體平台的「最低 RAM / VRAM」對照表。以下結合官方規格與實務開發經驗提供部署建議:
軟體環境要求
- 支援安裝最新 PyTorch 的 Python 執行環境;
- 具備 CPU、Apple Silicon MPS 或 NVIDIA CUDA 其中一種運算後端;
- 充足的儲存空間,以存放模型權重、相依套件、輸入素材及預測結果。
硬體部署建議基準
| 應用目標 | 最低實作起點 | 建議配置 | 適合模型規格 |
|---|---|---|---|
| 偶爾處理單張圖像 | 8GB RAM、純 CPU 運行 | 16GB RAM 或 Apple Silicon 晶片 | Small |
| 本機批量處理與短影片 | 16GB RAM、Apple Silicon 或中階獨立 GPU | 16–32GB RAM、配備 GPU / MPS 加速 | Small / Base |
| 高品質離線圖片生成 | 16GB 以上 RAM、具備充足 VRAM 的 GPU 或統一記憶體 | 24–32GB 以上 RAM / 統一記憶體 | Base / Large |
| 大規模影片處理與 API 服務化 | 需實測特定吞吐量下的記憶體佔用 | 配置多張 GPU,針對併發做最佳化 | Small / Base(視情況採用 Large) |
此表格僅作為專案規劃的起步參考,並非硬體相容性保證。實際的記憶體與顯示卡記憶體佔用量,還會受到以下變數的影響:
- 推論時的
input-size設定; - 輸入圖像的原始寬高比;
- 批量大小(Batch Size);
- PyTorch 的版本與內部優化機制;
- 運算後端(CPU、CUDA、MPS)的記憶體管理機制;
- 記憶體中是否同時載入了其他模型(如 LLM 或 Diffusion 模型);
- 推論過程中是否保存了中間層的張量;
- 影片的解碼與編碼管線所佔用的額外記憶體。
為什麼 Small 是最保險的評估起點?
雖然 Small 模型的權重檔案大小僅約 95 MiB,但程式執行時所需載入的內容遠不止於此:
- 模型本身的網路拓撲結構;
- 推論時各層產生的中間活化值(Activations);
- 輸入與輸出的張量數據;
- Python 與 PyTorch 框架本身的執行期開銷;
- 作業系統與背景其他程式佔用的系統資源。
因此,不能單純以「模型檔案 95 MiB」來推斷「在 1GB 的裝置上也能正常跑」。若部署環境僅有 8GB 記憶體,強烈建議從 Small 模型、單張處理、518 解析度開始測試,並避免在背景同時運行其他大型模型。
七、轉換一張圖片需要多久?
單張圖片的「總處理時間」實際上包含了三個階段:
載入與初始化模型
  + 單幀推論運算
  + 深度圖後處理與檔案寫入
官方並未提供跨硬體的基準測試數據。以下是在一台 16GB 統一記憶體 Apple Silicon Mac、PyTorch 2.13、預設 input-size 518、單張圖片、Batch Size = 1 環境下的實測時間供參考:
| 模型規格 | 運算裝置 | 暖機完成後的單張耗時 | 換算訊框率(FPS)與備註 |
|---|---|---|---|
| Small | CPU | 約 0.57 秒 | 約 1.75 FPS |
| Small | Apple MPS | 約 0.18 秒 | 約 5.7 FPS(首張圖因初始化顯著較慢) |
| Base | Apple MPS | 約 0.90 – 1.50 秒 | 波動範圍較大 |
| Large | Apple MPS | 無法完成運算 | 於 518 輸入尺寸下即觸發記憶體不足(OOM) |
上述數據並非官方標準基準測試,亦無法直接套用至 NVIDIA GPU 或 Windows 環境。其主要價值在於提供規模估算的依據:
- 處理少量圖片:Small 模型可在極短時間內完成;
- 數百張圖片的任務:Small 模型非常適合在本機進行批量處理;
- 品質優先的任務:建議先以 Base 進行測試,若要採用 Large,務必先確認硬體記憶體容量;
- 影片處理任務:總處理成本等同於「影片總影格數 × 單影格推論時間」。
模型首次載入時會伴隨明顯的冷啟動開銷。在此測試環境中,Small 載入約需 0.2–0.3 秒,Base 約 1 秒,Large 則需要 15 秒以上。若要將模型部署為 API 服務,應將其常駐於記憶體中,避免每次接收請求時重新初始化模型。
八、處理影片需要耗費多少時間?
官方程式庫中提供了 run_video.py,用於將影片拆解為單影格並生成對應的深度圖:
python run_video.py \
  --encoder vits \
  --video-path input.mp4 \
  --outdir video_depth_vis
若以 Small 模型在 Apple Silicon MPS 上實測的單張速度(約 5.7 FPS)進行粗略推算:
| 影片長度與規格 | 總影格數 | 純推論時間估算 |
|---|---|---|
| 60 秒、24 fps | 1,440 | 約 4.2 分鐘 |
| 60 秒、30 fps | 1,800 | 約 5.3 分鐘 |
| 60 秒、60 fps | 3,600 | 約 10.5 分鐘 |
若改用 Small 模型的純 CPU 推論(約 1.75 FPS),處理 60 秒、30 fps 的影片約需 17.1 分鐘;而 Base 模型在 MPS 實測速度下(約 0.91 FPS),處理同規格影片則需要約 33 分鐘。
實際的執行時間還需要加上:
- 影片的解碼與讀取;
- 每幀圖像的縮放與轉換;
- 深度數值的色彩對映(Color Mapping);
- 影片畫面的重新編碼與封裝;
- 磁碟 I/O 讀寫開銷與其他後處理。
在規劃影片工作流時,請務必先用短影片進行局部基準測試,切勿直接以模型的參數量來估算時間。
影片的時間連續性(Temporal Consistency)問題
雖然官方指出較大的模型規格在影片處理上能提供更好的時間連續性,但由於模型本質上是逐幀獨立預測,實務上仍可能遇到:
- 深度值在前後影格間輕微閃爍;
- 物件邊緣的深度範圍出現跳動;
- 畫面中有物體快速移動時,深度邊界產生模糊與不穩定;
- 遮擋關係在相鄰影格間出現不一致。
官方在 README 中也提及了後續研發的 Video Depth Anything,該專案專門為了解決長影片的時間連續性問題。若您要構建專業級的影片合成流水線,不建議直接將 V2 的單幀預測結果串聯後直接輸出。
九、如何將其整合至實際工作流程?
工作流 A:影像背景模糊管線
原始人像/商品照
  → 經由 Depth Anything V2 Small 處理
  → 輸出灰階深度圖
  → 對深度範圍進行正規化處理
  → 依像素深度值計算並套用高斯模糊
  → 人工檢查並修整邊緣邊界
  → 輸出最終景深商品圖或影片素材
工作流 B:靜態圖片轉 2.5D 動畫
靜態 2D 圖片
  → 預測深度圖
  → 依深度將影像分割為前、中、背景圖層
  → 設定不同圖層的虛擬相機位移參數
  → 針對位移露出的空白邊緣進行影像修補
  → 搭配字幕、音效與轉場效果
  → 匯出 2.5D 動態影片
工作流 C:深度引導的 AI 影像生成
輸入參考圖
  → 經由 Depth Anything V2 提取深度結構
  → 作為 Depth Conditioning 控制訊號
  → 輸入 Diffusion 模型進行局部重繪或生成
  → 與原圖進行空間構圖與遮擋關係的比對驗證
工作流 D:粗略 3D 重建與點雲生成
原始圖片
  → 套用 Metric Depth 模型
  → 搭配相機內參矩陣
  → 投影生成 3D 空間點雲
  → 濾除點雲中的離群雜訊
  → 導入 3D 建模或 CAD 軟體進行後續編輯
對於工作流 D,必須抱持極為審慎的態度。在缺乏精確相機內參、真實物理對照尺標以及多視角幾何約束的前提下,所生成的點雲僅適合作為空間佈局的粗略參考,無法直接用於嚴格的工程測量。
十、什麼情況下不建議使用 Depth Anything V2?
涉及安全防護的距離量測
例如:
- 自動駕駛系統的障礙物測距;
- 工業機械手臂的安全工作區域劃定;
- 無人機等高速移動載具的即時避障;
- 醫療手術輔助或人身安全決策系統。
單張圖片的單目深度估計,其精確度與可靠性不足以獨自承擔上述高風險任務。
需要高精密度的 3D 掃描
如果您的專案目標是:
- 室內空間的精準室內量房;
- 建築外觀的精密測量;
- 工業級物件的 3D 尺寸還原;
- 具備高度可重複性的公尺級 3D 數位化。
此時應優先考量 LiDAR、雙目相機、結構光深度相機、SLAM 或多視角立體重建(MVS),並將 Depth Anything V2 視為輔助的語意參考,而非唯一的測量依據。
需要影片深度絕對穩定無閃爍
雖然 V2 模型能提供逐幀的深度圖,但若要直接用於影視特效合成,仍需自行引入時間平滑濾波(Temporal Smoothing)、光流法(Optical Flow)或手動遮罩修正,或者改用專門的 Video Depth Anything 模型。
十一、我該如何選擇?
| 具體需求 | 建議的切入路徑 |
|---|---|
| 快速評估模型效果 | 瀏覽 Hugging Face 線上 Demo,或在本地運行 Small 模型 |
| 本機單張或批量圖片處理 | 採用 Small 模型,並將輸入尺寸設定為 518 |
| 製作圖片轉 2.5D 視差動畫 | 以 Small 模型生成深度圖,搭配 Inpainting 進行後製補洞 |
| 追求極致的邊緣與細節表現 | 採用 Base 模型,並針對同一批圖片進行 Small 與 Base 的 A/B 測試 |
| 評估室內物理距離 | 採用微調自 Hypersim 的 Metric Depth 模型,並驗證場景匹配度 |
| 評估戶外物理距離 | 採用微調自 Virtual KITTI 2 的 Metric Depth 模型,並驗證場景匹配度 |
| 處理大量影片素材 | 建立 Small / Base 模型的常駐服務,先行進行影格率(FPS)測試 |
| 開發商業產品或 API 服務 | 務必先仔細檢視各 Checkpoint 與程式碼的授權條款(License) |
| 精密 3D 重建或安防避障系統 | 僅將此模型作為多模態輔助輸入,絕不作為唯一感測來源 |
結論:它不是 3D 掃描器,而是極具成本效益的深度前處理工具
Depth Anything V2 的核心價值,在於將過去需要依賴專業硬體感測器或繁瑣人工標註才能取得的「前後空間層次」,精簡至只需單張 RGB 圖像即可快速估算出來。
它非常適合解決:
- 創意影像處理中缺乏深度資訊的困境;
- 2.5D 動畫製作時的前後景分層需求;
- 影像生成管線中所需的深度條件引導;
- 大批量素材自動化生成粗略深度圖的流程;
- 3D 重建或點雲流程的低成本初始化設定。
實務上最穩妥的導入路徑為:
載入 Small 模型
  → 設定輸入尺寸為 518
  → 測試約 20 張具代表性的場景圖片
  → 評估透明物體、反射材質及細節邊緣的預測表現
  → 評估是否需要升級至 Base / Large 或 Metric Depth 模型
在硬體資源的配置上,無需一開始便追求 Large 模型。Small 模型在純 CPU 及 Apple Silicon MPS 後端上均能穩定工作,16GB 記憶體的 Mac 已足夠用於本機的圖片處理與 2.5D 影片原型開發;Base 模型需考量推論耗時與記憶體佔用;而 Large 模型則應建議在配備大容量 VRAM 的工作站或專屬 GPU 伺服器上進行基準測試後,再評估是否正式導入。
若您的目標是創意視覺設計、短影音創作與 AI 生成前處理,Depth Anything V2 無疑是值得納入本機工具鏈的強大工具。但若涉及精準測距、3D 重建或安全性決策,它應被定位為整個多感測器系統中的其中一個輔助模組。
官方來源
- Depth Anything V2 官方 GitHub
- Depth Anything V2 官方專案頁
- Depth Anything V2 論文:arXiv:2406.09414
- Depth Anything V2 Transformers 文件
- Depth Anything V2 Small Hugging Face model
- Depth Anything V2 Metric Depth README
- Depth Anything V2 Small checkpoint
- Depth Anything V2 Base checkpoint
- Depth Anything V2 Large checkpoint
- Video Depth Anything
- Apple Core ML Models
本文所提及的推論速度數據,均基於一台 16GB 統一記憶體 Apple Silicon Mac、PyTorch 2.13、輸入尺寸 518、單張圖片、Batch Size = 1 的本機實測結果;此數據並非官方發布的跨平台基準測試。模型權重檔案大小是依據 Hugging Face 伺服器回應之 Content-Length 換算而得,實際的磁碟快取與執行期記憶體佔用會因具體軟硬體環境而有所不同。於商業環境部署前,請務必重新確認所選 Checkpoint 的授權條款,並於目標硬體上進行實測。
Signals
Visits
--
Waiting for Cloudflare metrics.